随着科研项目申请数量不断增加,同行评审所面临的时间压力和专家资源不足问题日益突出。大语言模型是否能够承担部分基金申请评价工作,成为人工智能进入科研评价领域后一个值得关注的问题。
JDIS最新发表的研究论文利用瑞典医学研究委员会(Swedish Medical Research Council, MRC)博士后奖学金申请数据,用中等规模的开源大语言模型生成的评价分数,与真实同行评审产生的专家评分进行比较,从而考察LLM能否在基金申请评价中呈现出与专家判断相一致的排序结果。
数据集包含142份博士后奖学金申请书, 每份申请已由独立评审人在三个维度上打分:研究问题、研究方法和申请者能力(0–4分量表)。
研究没有选择最大的商业云端模型,而是关注中型规模且有开放权重的大语言模型(LLM)。这类模型可以下载并在本地运行,适合用于处理包含敏感信息的科研基金申请。包括Gemma 3(27b)、Magistral Small (24b)、Llama Scout (17b)、Qwen3(32b)和DeepSeek-R1(32b和70b)。同时为了减少LLM输出中的随机性,每份申请被提交给每个模型5次,最终使用5次结果的平均分。
模拟评审人指令,要求 LLM 在三个维度上按 0–4 分打分,评分标准与人类评审人使用的量表一致。
为了考察不同信息量对LLM评价结果的影响,分别采用了“标题+摘要”和“标题+摘要+项目正文”两种输入方式。研究者由此获得不同模型、不同文本输入条件下的评价分数。
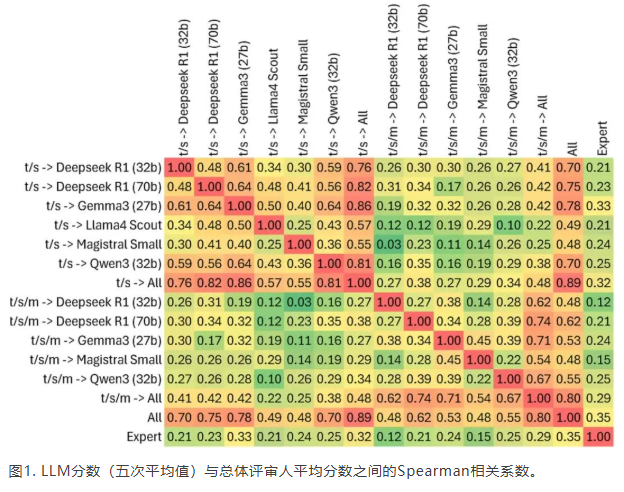
论文指出,LLM通常倾向于给出较高分数,因此具体分值本身未必具有直接可比性。对于科研基金评审而言,更重要的问题是:如果让LLM对申请进行排序,它所形成的排序与专家排序有多大程度的一致?因此,研究以Spearman相关系数作为主要分析指标,用来衡量LLM生成的排序与专家评分排序之间的一致程度。
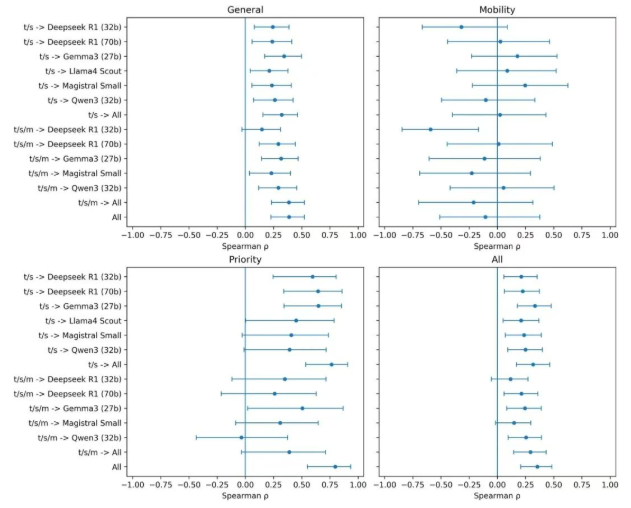
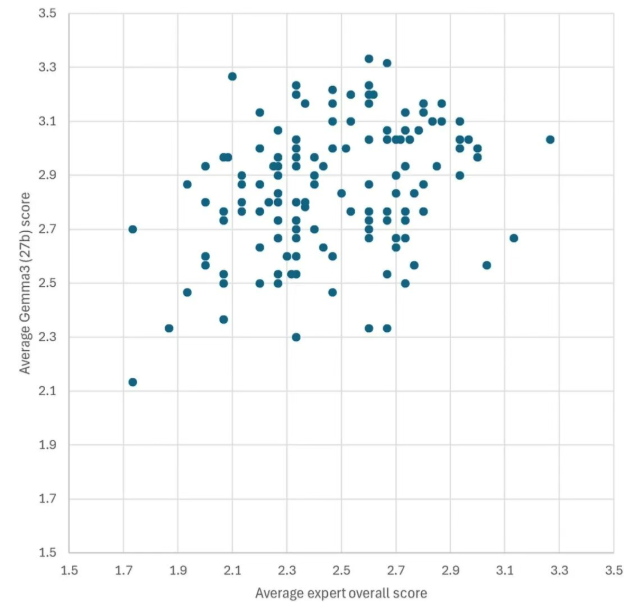
Gemma 3(27b)表现最好,其评分与人类专家评分的Spearman相关系数为0.33。LLM评分与专家评分总体呈正向弱相关关系, 这也意味着LLM的评价排序能力与专家评审水平仍有明显差距。
图1. LLM分数(五次平均值)与总体评审人平均分数之间的Spearman相关系数。
用标题加摘要打分与用完整正文打分的效果几乎没有差别。这表明LLM主要从文本表层提取与质量相关的线索(如主题、方法新颖性、语言流畅度),而非真正理解申请的深层构想和价值。研究将LLM的评分称为“模式匹配而非有意义的评价”。因此中等规模开源模型已能达到上述效果,无需依赖大型闭源模型。
图2. LLM与专家在“总体评分(Overall)”上的Spearman相关系数
研究结果并不支持“LLM可以直接替代专家评审”这样的结论。作者讨论了一种更谨慎的应用方式,即将LLM用于申请初筛:当申请数量远多于可资助数量时,用LLM筛掉明显不合格的申请,减轻评审人负担。西班牙La Caixa基金会已在实践中采用类似策略,用LLM筛选后,仅将排名靠前的申请提交给人类专家评审。
图3. Gemma 3 27b评分与专家总体评分的散点图
研究还指出:LLM评分可以作为专家评分的补充,用于交叉检查潜在偏见——例如识别那些不巧碰到多位严格评审人的申请,或是因评审人普遍宽松而得分偏高的申请。



 沪公网安备号:31010402006960 (网站)31010405000484 (蝌蝌APP)


 安全保密